‏إظهار الرسائل ذات التسميات بايثون Python. إظهار كافة الرسائل

مارس 05، 2010

سلسلة بايثون للمبتدئين - 06

سنتطرق اليوم إلى موضوع الدوال (functions) في بايثون. لكن أولا ما هي الدوال و لماذا نحتاجها ؟

الدوال هي عبارة أكواد مصدرية منفصلة عن بعضها من حيث البنية و مترابطة فيما بينها من حيث المضمون أو الغاية البرمجية. لتقريب الفكرة أكثر، الدوال هي عبارة عن تجزئة برنامج ما إلى أجزاء صغيرة.
لماذا؟
البرمجة تشبه كثيرا الكتابة، كتابة موضوع قصير لا يحتاج منا إلى فهرس و أقسام و عناوين مختلفة، يكفي فقط أن يكون الموضوع متراصا واضح الأفكار و سهل الأسلوب حتى يسهل إستعابه. لكن إذا تطور الموضوع ليصبح دراسة أو تشعب ليشمل العديد من النقاط و المضامين يصبح ضروريا تقسيمه إلى عناوين أساسية و أخرى فرعية حتى تسهل مناقشة و استيعاب تلك الدراسة. نفس الشيء ينطبق على البرمجة، كلما تطور البرنامج كلما احتاج إلى أن يجزأ إلى مجموعة من دوال، كل دالة عبارة عن حل لمشكلة بسيطة و تقوم بمهمة محددة.

كذلك من مميزات الدوال هو إمكانية إستخدامها اكثر من مرة عن طريق مناداتها بإسمها. مثلا إذا كان برنامجنا سيتحقيق من كلمة السر و إسم المستخدم لأكثر من مرة، يكفي أن يوضع هذا الكود داخل دالة و من ثما نستدعيها كلما أحتجنا التحقق من المستخدم. أيضا من مميزات الدوال تقليل العلل، سهولة تعديل الكود و تزيد حتى في درجة أمان و استقرار البرنامج.

إذا كانت لديك خلفية برمجية بسيطة فقد سمعت عن المهام (procedures) و هي شبيهة بالدوال إلى حد كبير. في الواقع الفرق بين المهام و الدوال هو أن هذه الأخيرة بعد الإنتهاء من عملها تخبر بالنتيجة التي توصلت إليها بينما المهام لا تفعل ذلك. في بايثون لا وجود للمهام، فقط الدوال. المهام في بايثون هي دوال تنتهي بنتيجة None.

بايثون كباقي لغات البرمجة يضم العديد من الدوال المدمجة كـ max, min, sum و غيرها حتى يوفر على المبرمج عناء تطوير كل شيء من الصفر و يعينه على التركيز في المهمة التي هو بصدد إنجازها.

في بايثون هنالك نوعان من الدوال، الدوال العادية و الدوال المجهولة الإسم (anonymous functions).


الدوال في بايثون :

لتحديد دالة نستخدم الكلمة المفتحية def يليها إسم الدالة ثم علامة : . الإسم يكون من إختيارنا و يفضل أن يكون له صلة بمضمون الدالة و ذلك حتى يسهل فهم البرنامج لاحقا سواءا منا أو فريق العمل الذي تعمل معه.
 مثال:
def  calc():
    x = 10
    y = 6
    return x + y


print calc()

في هذا المثال قمنا بتحديد/إنشاء دالة بإسم calc(). لاحظ جيدا أن إضافة القوسين و : بعد إسم الدالة إجباري.
داخل الدالة قمنا بتحديد المتغيرة x التي أسندنا لها قيمة 10، و المتغيرة y أسندنا لها العدد 6.
بعد ذلك سنرجع مجموع x و y باستخدام الكلمة المفتحية return
بعد كتابة الدالة قمنا باستدعائها من عن طريق print التي ستعرض على الشاشة النتيجة التي توصلت بها من الدالة بعد انتهاء هذه الأخيرة من عملها.

الآن ماذا لو أردنا من الدالة calc() أن تحسب قيمة x و y مختلفة عما هي عليه الآن؟ هل نكتب دالة جديدة لحساب كل قيمتين جديدتين؟ الجواب هو لا. يكفي فقط تعديل الدالة السابقة من خلال استخدام ما يعرف بالمعايير (arguments).

المعايير يمكن إعتبارها كحقول يمكن ملئها بمعلومات أو قيم لكي تستخدمها الدالة لإنجاز مهمتها.

الدالة السابقة ستصبح كما يلي بعد إستخدام المعايير:
def  calc(a, b):
    x = a
    y = b
    return x + y


print calc(10, 3)
print calc(20, 80)

التغييرات التي طرأت هي كما يلي:
في السطر الأول أضفنا معيارين هما a و b مفصولين بعلامة ,
القيمة المسندة للمتغيرة x هي قيمة المعيار a و قيمة المتغيرة y هي قيمة المعيار b
عند المناداة على الدالة calc() يتم إسناد العدد 10 كقيمة للمعيار a و العدد 3 كقيمة للمعيار b
و ليتضح المثال نادينا عليها مرة ثانية بقيمتين مختلفتين، و بالطبع ستكون النتيجة الثانية مختلفة عن الأولى :)

طبعا بايثون يقدم مرونة أكثر تتمثل في:
إمكانية إستخدام معايير بقيمة مسبقة أو إفتراضية،
إمكانية إستعمال معيار بقيم متعددة،
إمكانية إستخدام معيار متعددة على شكل قواميس.

* مثال لدالة calc() بإستخدام معيار ذو قيمة محددة مسبقا:

def calc(a, b=10):
    x = a
    y = b
    return x + y


print calc(50)
print calc(30, 60)

لاحظ معي أن عند كتابة المعيار b أضفنا له =10 و هذا يعني أن قيمته الإفتراضية تساوي 10.
في السطر الأول الذي ينادي على calc() كتبنا قيمة واحدة و مع ذلك كانت النتيجة هي 60.
ثم عاودنا تشغيل الدالة بمعيارين فكانت النتيجة هي 90 بدلا من 40 و هذا يعني أن القيمة الإفتراضية للمعيار b تم تبديلها بالقيمة المدخل أثناء تشغيل الدالة.


* مثال لدالة calc() بإستخدام معيار ذو قيم متعددة:
def calc(a, *b):
    x = a
    y = 0    
    for i in b:
        y = y + i

    return x + y


print calc(10, 15, 18, 17, 40)

لاحظ جيدا أن المعيار الثاني مسبوق بـ * و هو ما سيجعله قابل لإستيعاب أكثر من قيمة.
لإستخراج كل القيم من المعيار b إستخدمنا الحلقة التسلسلية for. في كل دورة نضيف مجموع المتغيرة y و i على القيمة السابقة ل y
عند إنتهاء الحلقة for ستكون قيمة المتغيرة y هي مجموع كل قيم المعيار b

لاحظ جيدا أنه رغم تحديد معيارين فقط للدالة calc() فقد كتبنا خمسة قيم عند تشغيلها. القيمة 10 سيحتفظ بها داخل المعيار a و 15,18,17,40 ستحفظ داخل معيار واحد ألا و هو b


مثال لدالة calc() بإستخدام معايير متعددة على شكل قاموس:
def calc(a, **b):
    x = a
    y = 0
    
    for k, v in b.items():
        print k, "=", v
        y = y + v

    return x + y

print calc(10, t=15, r=18, u=17, g=40)

لاحظ جيدا أن المعيار الثاني مسبوق بـ ** و هو ما سيجعله قابل لإستيعاب أكثر من معيار و قيمته.
هنالك إختلاف بسيط بين هذا المثال و المثال السابق. بالنسبة للحلقة for إستخدمنا المتغيرة k و v للتعبير عن المفتاح و قيمته (راجع التدوينة الخاصة بالقواميس) بالنسبة للمعيار القاموس b. في كل دورة يتم عرض إسم المفتاح المعبر عنه ب k و قيمته المعبر عنه ب v. و بعدها يتم إضافة قيمة v على المجموع السابق ل y.
عند تشغيل الدالة أدخلنا قيمة المعيار a و هي 10 ثم بعدها حددنا أسماء المعايير و قيمتها تماما كما نفعل عند إنشاء الدوال. هذه الميزة تسمح بإنشاء دوال غاية في المرونة.


الدوال المجهولة الإسم :

دعم الدوال المجهولة (أو الغير المعرفة) يعتبر من مزايا لغات البرمجة الحديثة التي تحاول تقديم مختلف أساليب التعبير في البرمجة. الدوال المجهولة تدخل في أساسيات البرمجة الدلالية/الوظيفية (functional programming) و هو أسلوب آخر في البرمجة يرتكز الدوال في كل شيء، يمكن إعتبار هذا النوع من البرمجة أكثر ملائمة لمتخصصي الرياضيات. يمكن إعتبار لغة Haskell من أشهر اللغات الوظيفية.

بايثون يقدم دعم لا بأس به للبرمجة الدلالية و ذلك يتمثل بالدرجة الأولى في lambda ثم  map.

لنقم بإعادة صياغة الدالة calc() بإستخدام lambda
f = lambda x, y: x + y
print f(10, 20)

أول شيئ يلاحظ هو تقلص للعدد السطور. جميل أليس كذلك؟ لنشرح السطر الأول.
نقوم بتحديد دالة مجهولة الإسم مستخدمين كلمة lambda يليها معيار x و y. بعد ذلك نضيف : للفصل ثم نكتب كيف سيعمل المعيارين. في مثالنا نقوم بجمع x و y. ثم نقوم بإسناد هذه الدالة إلى f لتصبح بذلك ممثلة للوظيفة.
في السطر الثاني تعرض print قيمة النتيجة التي توصلت إليها f بإستخدام قيمة المعيارين x و y

قد تظهر الدوال المجهولة الإسم و كانها صعبة و قد تكون كذلك في البداية لكنها عملية جدا.

مثال آخر:
say_hi = lambda name: "Hi " + name
friends = ["Ayman", "Karim", "Nour", "Youness"]
for friend in friends:
    print say_hi(friend)

في هذا المثال قمنا بتحديد دالة lambda بمعيار واحد و هو name و الذي ستضيف إليه كلمة "Hi " حتى تظهر على شكل تحية بالإنجليزية. هذه الدالة يعبر عنها ب say_hi
ثم نكتب قائمة بإسم friends نسند إليها كل أسماء أصدقائنا.
و لنحي كل واحد منهم علينا أن نستخدم الحلقة التسلسلية for. في كل دورة يتم إستدعاء say_hi و تسند إليها قيمة (عبارة إسم صديق) مختلفة.

المثال السابق يختصر علينا سطرين أو ثلاثة لو كتبناه بإستخدام الدوال العادية، و رغم ذلك يمكن إختصاره مجددا ليصبح في سكرين بإستخدام الدالة map. إليكم المثال:
friends = ["Ayman", "Karim", "Nour", "Youness"] 
print map(lambda name: "Hi " + name, friends)
ما توفره دالة map هو إمكانية كتابة كود lambda كالمعيار الاول لـ map ثم القائمة friends كمعيار ثاني. بعد ذلك تقوم print بعرض النتيجة.

و يمكن إختصار السطرين السابقين في سطر واحد، إليكم المثال:
print map(lambda name: "Hi " + name, ["Ayman", "Karim", "Nour", "Youness"])

طريقة عمل map() هي كالتالي: كل قيمة في القائمة يتم تمريرها كمعيار للدالة. map شبيهة بالحلقة for لكنها تبقى متميزة في الإستخدامات مع الدوال و ربطها بالقوائم.


تريد تعلم المزيد؟
إليك موضوع الصديق أحمد يوسف بخصوص الدوال أو كتاب بايثون.


ملاحظة: بعد التعريف بالدوال و طرق إستخدامها سأطرح مشاكل جديدة للمشروع يولر Euler Project.

يناير 07، 2010

سلسلة بايثون للمبتدئين - 05

في البداية آسف إن تأخرت عن تكملة هذه السلسلة التعليمية الخاصة ببايثون للمبتدئين. اليوم سنتعلم إستخدام الحلقات (loops) و الجملة الشرطية (If)، لن يأخذ ذلك منا الكثير من الوقت و سيكون ممتعا.

المقدمة:

أولا، ما معنى الحلقات في البرمجة و ما الفائدة منها؟
قبل تعريف الحلقات و دورها/وظيفتها علينا أن نتذكر أننا نبرمج حتى يسهل علينا التعامل مع المعلومات، تخزينها و تحليلها بشكل سريع و دقيق. الكثيرون ينظرون إلى البرمجة على أساس أنها وسيلة لإيجاد الحلول للمشاكل الحسابية و المعلوماتية أو حتى المشاكل اليومية البسيطة.

الحلقات كما نفهم من خلال التسمية تعني أن كود برمجي ما سيتكرر لعدد من المرات.

لماذا سيتكرر الكود أكثر من مرة؟
لنتصور مع بعض أننا على وشك أن نقوم بطبع كشف حساب أجرة مجموعة من الموظفين في آخر الشهر؛ و مع العلم أن أجرة كل موظف قد تختلف عن الآخر (نظرا للرتبة أو عدد ساعات العمل و الغياب) فإنه على العموم سيكون هنالك تشابه كبير بينهم لأننا سنقوم بنفس العملية لكل موظف.

و مثال آخر هو أن يطلب منا إعداد نتائج الطلاب السنوية أو الدورية. تصور حجم التكرار و المجهود و التركيز حتى ننجز هذه المهمة يدويا، في الوقت الذي يمكننا كتابة كود مصدري يشبه التالي: "في كل مستوى من مستويات المدرسة قم بإخراج نتيجة كل طالب من الطلاب المسجلين بإستخدام الشكل التالي مع مراعات تفاصيل كل طالب".

=> تذكر جيدا أن الحلقات تجعل من الروتين و المهام الروتينية أمرا سهلا و غايتا في البساطة و السلاسة.

أكمل بقية الموضوع

ديسمبر 25، 2009

كيف يمنك الحصول على بيئة برمجية متكاملة لبايثون و باي كيوت PyQt بإستخدام إكليبس Eclipse و PyDev على جنو/لينوكس، ويندوز و ماك

سبق و أن كتبت تدوينة بخصوص أفضل محرر في رأيي آنذاك للبرمجة بلغة بايثون. الآن أستخدم محرر و بيئة Eclipse للبرمجة بكل من بايثون Python، روبي Ruby و بي إتش بي Php. محرر و بيئة إكليبس بالإضافة إلى دعمها الممتاز لتلك اللغات فهي متوفرة على منصة ويندوز و جنو/لينوكس و ماك، و متوفرة في شكل تطبيق متنقل (portable) يسهل إستخدامه دون الحاجة إلى تثبيته على كل جهاز تعمل عليه.

سنرى مع بعض كيف يمكننا الحصول على هذه البيئة و إعدادها لدعم البرمجة بكل من بايثون ( و روبي في تدوينة لاحقة).التحديث في آخر التدوينة


ديسمبر 24، 2009

مسئلة برمجية: حساب و رسم مثلث باسكال

لنقم ببعض التسخينات البرمجية! هممم، ماذا عن مثلث باسكال؟

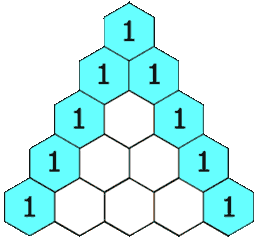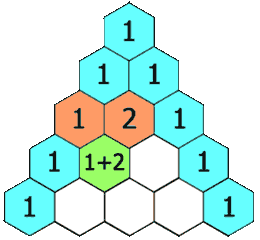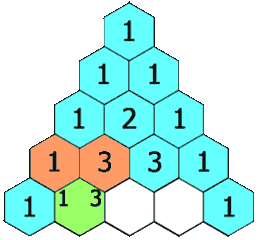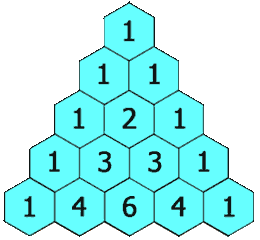
ستكون المسئلة البرمجية هي حساب مثلث باسكال و رسم صفوفه. يجب أن تظهر النتيجة على شكل مثلث و لذلك يجب أن تكون المسافة التي تفصل أي عددين عن بعض بطول أكبر عدد في المثلث.

مثال:

القاعدة الحسابية لملء مثلث باسكال تقوم على : كل عدد في مثلث باسكال هو مجموع العددين الذان فوقه.

لا تهم اللغة البرمجية المستخدمة لحل هذه المسألة، ليتقدم الكل لإيجاد الحل.
سأكتب الحل الذي توصلت إليه بإستخدام بايثون بعد يومين.

الحل الذي توصلت إليه هو:


أغسطس 22، 2009

سلسلة بايثون للمبتدئين - 04

سنتعلم اليوم مجموعة من الأشياء الجديدة بخصوص المتغيرات النصية و القوائم. بالإضافة إلى تعريف القواميس و طريقة إستخدامها.

المتغيرات ككائنات: المتغيرات النصية
لنقم بتعريف المتغيرة msg كما يلي:
msg = "learning python is fun!"

الآن لنقم بتنفيذ:
print msg
النتيجة هي أننا نقوم بعرض محتوى المتغيرة msg و بما أنه سبق و أن تعلمنا (في التدوينة السابقة) أن هذه المتغيرات يمكن أن نتعامل معها ككائنات فسنقوم بإكتشاف بعض وظائفها. لننفد ما يلي:
print msg.upper()
فتكون النتيجة هي:
LEARNING PYTHON IS FUN!
.upper() هي وظيفة تقوم بتحويل حروف الرسالة النصية إلى الأحرف الكبيرة.

ننفد بعدها:
print msg.title()
.title() وظيفة تقوم بتكبير الحرف الأول من كل كلمة لنحصل على رسالة مكتوبة على شكل عنوان.

بعدها قم بعرض محتوى msg من جديد:
print msg
تظهر الرسالة على شكلها الأصلي و لم تتغير أحرفها رغم تنفيذ .upper() أو .title() لماذا؟ لسبين:
1.  .upper() و .title() من الوظائف، و الوظائف تقوم بإرجاع (returns) نتيجة العملية التي قامت بها و لا تغير الأصل.
2. لأن المتغيرة msg هي من النوع str (متغيرة نصية) و هذا النوع يعتبر immutable بمعنى أن قيمته ثابتة أو غير قابلة للتغيير!

ستتساءل ما هذا الهراء؟ متغيرة غير قابلة للتغيير!؟ *o*
صبرك علي حتى أشرح :)
عندما نكتب
msg = "learning python"
يتبادر إلى دهننا أن المتغيرة msg تحتوي/تساوي تلك القيمة "learning python". في الواقع عند بايثون لا. بايثون ينسب مٌعرف المتغيرة msg إلى القيمة و ليس العكس (ينسب القيمة إلى مٌعرف المتغيرة كما نعتقد).
و عندما نقوم بتغيير القيمة من "learning python" إلى "hello python" مثلا:
msg = "hello python"
فما يطرأ هو أنه يتم حجز مكان جديد من الذاكر يكتب فيه "hello python" ثم يُعرف بـ أو ينسب إليه المُعرف msg، و تترك القيمة الأولى في الذاكرة إلى أن يقوم بايثون بكنسها من خلال garbage collector بطريقة تلقائية (لا نتدخل في ذلك كمبرمجين)

هذه هي الطريقة التي يعمل بها بايثون من الداخل و هذا هو معنى immutability (إنعدام قابلية التغيير) في المتغيرات.

هنالك العديد من وظائف التي يمكن إستخدامها مع النوع string و يمكن الإطلاع عليها على موقع التوثيق الخاص ببايثون


المتغيرات ككائنات: القوائم

نقوم بتعريف المتغيرة names كما يلي:
names = ["Wael", "Farid", "Ali", "Jamal"]
عدد العناصر هو 4 و أول عنصر ترتيبه هو 0
print names[0]

إذا أردنا أن نضيف أي عنصر جديد يمكن إستخدام إحدى هذه الطرق:
names = names + ["Karim"]
أو
names += ["Adel"]
أو
names.append("Amal")
أو
names.extend(["Noura"])

طبعا هنالك إختلاف بسيط بينهم من حيث الطريقة التي يتم بها إضافة العنصر/العناصر إلى القائمة، لكن لا تهمنا تلك التفاصيل. الأفضل من حيث السرعة هي names += ["Adel"]

كل تلك الطرق تقوم بإضافة العنصر الجديد إلى آخر القائمة. أما إدا أردنا إضافة عنصر إلى بداية القائمة مثلا يكفي أن نستخدم .insert() كالتالي:
names.insert(0, "Fouad")
.append() .extend() و .insert() كلها وظائف تعمل مع القوائم أو الكائن list

بالنسبة لقابلية التغيير (mutability) فإن قوائم تتغير، أي على عكس المتغيرات النصية string. لنقم بتنفيذ ما يلي:
print names
تقوم بعرض محتوى المتغيرة names بأكمله
names.reverse()
تقوم بعكس رتبة كل عنصر داخل القائمة (الأول يصبح الأخير و الأخير يأخذ مكان الأول)
print names
تقوم بعرض المحتوى من جديد و يظهر جليا التغير الذي طرأ على names. ثم إذا قمنا بتنفيذ الأمر التالي نحصل على قائمة بعناصر مرتبة حسب الترتيب الأبجدي.
names.sort()
print names

هذا كل شيء تقريبا بخصوص المتغيرات النصية و القوائم بإعتبارها ككائنات في هذه السلسلة من التدوينات و يمنك تعلم المزيد من خلال قراءة كتاب بايثون. كل ما تبقى هو جزئية بسيطة بخصوص الحلاقات التسلسلية for و الجمل الشرطية if و طريقة إستخدامها مع القوائم.


قبل أن نكمل هنالك ملاحظة بسيطة: يمكن تعريف و إستخدام قوائم صالحة للقراءة فقط تسمى بـ tuples و يتم تعريفها بإستخدام الأقواس () بدلا من []
speed = (25, 50, 75, 100)
في هذه الحالة نضمن أن تلك القائمة لن تستطيع إكتساب/إضافة عنصر جديد إليها.


القواميس (dictionaries)

القواميس مثلها مثل القوائم تسمح بالإحتفاظ بأكثر من معلومة داخلها، بالإضافة إلى أنها تسمح بالتميز بين كل مجموعة من المعلومات و آخرى من خلال تسميات مفتحية تماما كالقاموس.

المتغيرات/الكائنات على شكل قواميس تتشكل من قسمين القسم الأول يضم القيمة المفتحية و القسم الثاني يضم القيمة أو القيم المعبَر عنها.

و تكتب القواميس بين علامتي {} و يُفصل بين القسمين بعلامة :
مثال:
students = { "id100" : "Youssef", "id120" : "Adel", "id121" : "Noura", "id133" : "Karim" }

في هذا المثال قمنا بتعريف متغيرة على شكل قاموس إسمها students و تضم أربعة عناصر. كل عنصر يضم التسمية المفتحية و قيمتها.
العنصر الأول هو "id100" : "Youssef" تسميته المفتحية هي "id100" و قيمته التي يعبر عنها هي "Youssef"

لعرض محتوى المتغيرة بأكمله ننفد:
print students

لعرض محتوي إحدى التسميات المفتحية، مثلا "id120" ننفد:
print students["id120"]

لعرض كل التسميات المفتحية للمتغيرة students ننفد:
print students.keys()

لعرض كل القيم المتواجدة داخل المتغيرة students ننفد:
print students.values()

لإضافة تسمية مفتحية و قيمتها ننفد:
students["id116"] = "Ayman"
print students

لتعديل أي عنصر "id120" ننفد:
students["id120"] = "Farid"
print students

لحذف أي عنصر "id133" ننفد:
del students["id133"]
print students


القواميس تجعل من التعامل مع المعطيات/المعلومات المركبة أمرا سهلا، و يمكن إعتبارها كنوع من أنواع قواعد البيانات البسيطة.

ملاحظتين بخصوص القواميس:
1. القواميس مثلها مثل القوائم من حيث قابلية التغيير (mutable)
2. القسم الثاني الذي يعبِر عن القيمة يمكن أن يأخذ أي شكل من المتغيرات سواءا كان نصي، عددي، قائمة، كائن، وظيفة أو حتى قاموس آخر.

أغسطس 19، 2009

سلسلة دروس بايثون المرئية

سلسلة دروس بايثون المرئية متوفرة على يوتوب مكونة من 12 جزء و يمكن تحميلها على شكل ملفات wmf من هنا.
شكر خاص للمعد!

أغسطس 16، 2009

Ð0 ¥0µ $p34k £33†?

تحية روبية للصديق كريم عبد المجيد أما بعد، تقبل رسالة l33t على الطريقة البايثونية :)


#!/usr/bin/env python

# -*- coding: UTF-8 -*-

## Released into Public Domain by Mohammed Berdai <stuntgp2000 @t gmail d0t com>
## To know more about Leet visit URL: http://en.wikipedia.org/wiki/Leet
## Thanks flies to Mutati0N for the fun http://mutati0n.wordpress.com/ruby-projects
"""English to l33t Convertor"""
 

alphabet = {'a':'4', 'b':'8', 'c':'[', 'd':'|>', 'e':'3', 'f':'|=', 'g':'6',

            'h':'/-/', 'i':'1', 'j':'_/', 'k':'|<', 'l':'|_', 'm':'(V)',

            'n':'/V', 'o':'0', 'p':'|>', 'q':'<|', 'r':'|?', 's':'$',

            't':'7', 'u':'(_)', 'v':"\/", 'w':'vv', 'x':'}{', 'y':'`/',

            'z':'2'}


print "\t\tWellcome to the l33t Converter V1.0\n"

phrase = raw_input('Please enter the phrase: ').lower()


leetphrase = ''

for char in phrase:

    leet = alphabet[char] if char in alphabet else char

    leetphrase += leet


print leetphrase


و حتى أجيبك K.O  إليك:


#!/usr/bin/env python

# -*- coding: UTF-8 -*-

## Released into Public Domain by Mohammed Berdai <stuntgp2000 @t gmail d0t com>
## Leet URL: http://en.wikipedia.org/wiki/Leet
## Thanks flies to Mutati0N for the fun http://mutati0n.wordpress.com/ruby-projects


alphabet = {'a':'4', 'c':'ç', 'd':'Ð',  'e':'3', 'f':'ƒ', 'g':'9', 'i':'1',

            'l':'£', 'o':'0', 's':'$', 't':'†', 'u':'µ', 'y':'¥', 'z':'2'}


print ''.join([(alphabet[c] if c in alphabet else c) for c in raw_input('Your phrase: ').lower()])

لا تقلقوا أنا بخير :)

l33t هي لغة يستخدم فيها الرموز و الأرقام للكتابة باللغة الإنجليزية متداولة بين مستخدمي الحاسوب الذين يعتقدون أنهم متميزون عن البقية :)

و هذا المساء دخلت إلى قسم مشاريع بروبي Ruby على مدونة Mutati0N و لتسلية فقط أردت أن اكتب سكريبت ببايثون Python يقوم بنفس العملية (تحويل الجمل من الإنجليزية إلى l33t) بأقل عدد من الأسطر و كانت النتيجة كما رأيتم :)

جيد، الشرح:
في الكود المصدر الأول إستخدمت متغيرة على شكل قاموس (سنرى القواميس لاحقا في سلسلة بايثون للمبتدئين) إسمها alphabet و هي تضم كل أحرف اللغة الإنجليزية و مقابلها من أحرف l33t. بعد ذلك نقوم بعرض رسالة تتضمن إسم السكريبت و رقم إصداره، ثم نطلب من المستخدم أن يدخل جملته التي سيتم تحويلها إلى الأحرف الصغيرة قبل أن يتم الإحتفاظ بها في المتغيرة phrase
بعد ذلك نحدد متغيرة إسمها leetphrase و محتواها في البداية يكون فارغ.
الآن سنقوم بقراءة كل حرف (معبَر عنه بالمتغيرة char) في الحملة التي أدخلها المستخدم (معبَر عنها بالمتغيرة phrase) بإستخدام الحلقة التسلسلية for. و في كل دورة من دورات الحلقة يتم إختبار هل الحرف الحالي يوجد مقابل له في القاموس أما لا (و ذالك بالإستخدام الجملة الشرطية if). إذا كان موجودا كُتب الحرف المقابل له في المتغيرة leet، أما إذا لم يكن موجود كُتب الحرف الحالي (الأصلي) في المتغيرة leet. ثم بعد ذلك يتم إضافة قيمة المتغيرة leet إلى الجملة التي ستظهر للمستخدم لاحقا (المعبر عنها بالمتغيرة leetphrase) بعد إنتهاء الحلقة من المرور على كل حرف في الجملة التي أدخلها المستخدم.
في النهاية يتم عرض محتوى المتغيرة leetphrase التي تضم مقابل الجملة الأصلية بلغة l33t


أما الكود الثني فهو يقوم بنفس عمل الكود الاول لكن في سطرين. الأول يٌعرف القاموس و الثاني:
يطلب من المستخدم أن يدخل الجملة و يقوم بتصغير حروفها من خلال الجزء التالي raw_input('Your phrase: ').lower()
يقرأ كل حرف (معبر عنه بـ c) من خلال الحلقة التسلسلية for، ثم يتم إختباره من خلال الجملة الشرطية if هل موجود في القاموس أم لا. إذا كان موجود عُوض بمقابله، إذا لم يكن موجود ترك الحرف الأصلي على حالته.
كل ذلك يتم داخل قائمة [] يتم تحويل كل عناصرها إلى جملة نصية واحدة من خلال ''.join() و في النهاية يتم عرض النتيجة للمستخدم :)

أغسطس 15، 2009

سلسلة بايثون للمبتدئين - 03

لنتذكر مع بعض أهم الأشياء التي تعلمناها إلى الآن:
  • المتغيرات وسيلة لتخزين المعطيات/البيانات/المعلومات.
  • كل متغيرة تعبر عن معلومة معينة.
  • نحن من نعطي المتغيرة إسم و يفضل أن يتناسب مع المعلومة التي ستعبر عنها.
  • سمية متغيرات لأن محتواها يمكن أن يتغير في الوقت الذي تضل تحافظ على الإسم الذي أعطيناها.
  • المعطيات/البيانات/المعلومات تختلف فيما بينها حسب نوعيتها. فكما نجد أن هنالك أرقام، نجد الرسائل النصية أيضا أو أي شيء آخر كالصور و ...
  • الأرقام تختلف في ما بينها من حيث هل ستعبر عن عدد صحيح طبيعي (عدد بدون الفاصلة) أو عدد حقيقي (عدد بالفاصلة)
  • الرسائل النصية تكتب بين علامتي "" أو ''

المتغيرات قد تتخذ شكل مركب كالقوائم (lists) أو القواميس (dictionaries). و في بايثون كما أغلب لغات البرمجة الحديثة يمكن للمتغيرات أن تعبر و تستوعب أي شيء. و هذا ما سيدفعنا إلى التطرق إلى مفاهيم البرمجة الكائنية التوجه (Object-oriented programming) و التي يعتبر كل شيء فيها كائن.

ماهي البرمجة الكائنية التوجه؟
هي نوع من أنواع برمجة الحاسوب التي تسمح بالتعامل مع المعطيات و كل جزء من البرنامج على أساس أنها كائنات تتميز بخصائصها و وظائفها و إستقلاليتها بذاتها من جهة، و بتفاعلها مع بعضها البعض و إعتمادها على كائنات أخرى للحصول على تلك الميزات من جهة أخرى.

و حتى تتقرب الفكرة أكثر سأعطي مثال قطعة الورق. كل قطعة ورق تتميز بطول و عرض معينن يشكلان المساحة الصالحة للكتابة (خصائص قطعة الورق). كما قد تكون ملونة أو بها أسطر للإعانة على الكتابة. و قطعة الورق تلك صالحة للكتابة (وظيفتها)
كما إذا تم تجمع عدد معين من قطع الورق يمنكن أن نحصل دفتر، و هو بدوره يتميز بخصائصه (عدد الأوراق، نوعيتها، المساحة، نوعية الغلاف الخارجي). هذا الدفتر يعتبر كائن جديد إكتسب خصائصه من مجموع قطع الورق، كما لذيه خصائصه التي تميزه بذاته. و وظيفته هي الإحتفاظ بما يكتب عليه.
هكذا هي البرمجة التي تعتمد على الكائنات.

الآن سنعود إلى ذلك الجزء .upper() في آخر المتغيرة lastname في التدوينة السابقة.

lastname هي متغيرة، و القيمة التي تعبر عنها هي نصية (string)، و بما أن بايثون لغة برمجة كائنية التوجه فهذا يجعل من تلك المتغيرة كائن و خصائصه يستدمها من القيمة الني يعبر عنها، و بما أن هذه القيمة هي نصية فإن خصائصها مستمدة من كائن إسمه str و هذا الأخير واحد من كائات بايثون.

upper() هي من وظائف الكائن str، و تسمى أيضا بالدوال. إكتسبت المتغيرة lastname تلك الوظيفة لأنها إكتسبت خصائص الكائن str

نفس الشيء ينطبق على المتغيرة countries التي تعتبر قائمة (متغيرة تضم مجموعة من القيم على شكل قائمة). هذه المتغيرة تعتبر كائن لأنها تستمد خصائصها من كائن إسمه list. بالإضافة إلى ذلك فإن كل قيمة متواجدة داخل تلك القائمة تكتسب خصائصها حسب نوع المعلومة أو الكائن الذي تعبر عنه. في حالتنا نحن فإن القيم داخل القائمة هي نصية و بذلك فإن كل واحدة تستمد خصائصها من الكائن str

تدوينة اليوم جد مهمة لأنها توضح طبيعة البرمجة ببايثون و تشرح بعض النقاط و التفاصيل المهمة التي سنعتمد عليها مستقبلا لتكمل سلسلة البرمجة ببايثون.

أغسطس 11، 2009

سلسلة بايثون للمبتدئين - 02

في التدوينة السابقة قمنا بخطواتنا الأولى لتعلم بايثون، و اليوم سنرى المزيد بخصوص المتغيرات.

أهم شيء تعلمناه هو أن بايثون يُميز بين المحتوى النصي و العددي من خلال علامتي ""، كما يمكن أن نستقبل المعطيات المدخلة و الإحتفاظ بها داخل المتغيرات. لكن لماذا نحتفظ بها بإستخدام المتغيرات؟
نحتفظ بها حتى يسهل علينا التمييز بين مختلف المعطيات (مثلا إسم الزبون، نتائج الإختبارات، درجة حرارة الفرن، سرعة المحرك..) و يسهل التعامل بها من أجل إجراء كافة العمليات التي نريدها.

لكن ما نوع هذه العمليات؟
على سبيل المثال يمكن أن نطلب من المستخدم أن يدخل نسبه بالعجمية. لكنه عند إدخاله قد يكتبه بالأحرف الصغيرة (abcd) أو الكبيرة (ABCD)، و نحن نريد أن نعرض إسمه دائما بالأحرف الكبيرة فكيف نفعل ذلك؟
سنكتب ما يلي:
lastname = raw_input("Please enter your last name: ")
print  "Welcome back " + lastname.upper()

في السطر الأول تقوم raw_input() بعرض رسالة "Please enter your last name: " ثم تنتظر من المستخدم أن يدخل المعلومة المطلوبة. و بعد التوصل بها يتم حفض النتيجة داخل المتغيرة lastname
في السطر الثاني تقوم print بعرض رسالة تتألف من جزء ثابت و محدد هو "Welcome back " و جزء متغير متواجد داخل lastname.upper()
ملاحظتين:
1. يسمى جزء متغير لأن محتواه يتغير بحسب محتوى المتغيرة، و هذه الأخيرة محتواها يتغير حسب المعلومة التي توصلت بها (النسب في هذه الحالة)
2. لاحظ أن lastname أصبحت lastname.upper() لماذا؟. upper() هي وظيفة يمكن تطبيقها على المتغيرات النصية. سنرى الوظائف لاحقا، المهم أن هذه الوظيفة هي نوع من أنواع العمليات التي يمكن تطبيقها على المحتوى/المتغيرات النصية. العملية التي تقوم بها upper() هي تكبير حروف المتغيرة lastname و بذلك نضمن أن النسب سيظهر دائما بالأحرف الكبيرة.


جيد، تعلمنا أن المتغيرة تصلح لتخزين المعطيات كما يمكن إستخدام هذه المعطيات و إجراء مجموعة من العمليات عليها.
العمليات التي يمكن إجرائها عديدة و لا يمكن التطرق لها حاليا حتى يبقى الموضوع سهل الإستيعاب.

سؤالي إدا كنا نريد الحصول على أسماء 5 أشخاص فهل يجب إستخدام 5 متغيرات؟ ماذا لو كان عدد الأشخاص 100؟ أو عدد الأشخاص غير معروف كعدد الزبائن مثلا؟
في هذه الحالة يفضل أن نستخدم القوائم (Lists)

القوائم:
القائمة هي متغيرة يمكن أن تستوعب أكثر من معلومة واحدة، و حتى يمكن الوصول إلى أية معلومة من تلك المعلومات المخزنة يتم إستخدام الرتبة. تبدوا صعبة و لكن بعد التوضيح و التطبيق ستبدو على العكس تماما :)

قم بتحرير ما يلي:
countries = []
ثم
countries = ["Algeria", "Palestine", "UK", "France"]
ثم
countries.append("China")
ثم
countries.append("Germany")
ثم
print countries[1]
ثم
print countries[0]
ثم
print countries[-1]
ثم
print countries[2:4]
ثم
print countries
الشرح:
أولا نقوم بتحديد متغيرة بإسم countries و محتواها سيكون على شكل قائمة. المعقوفات [] تستخدم لتعبير على أن المتغيرة هي قائمة فارغة (لا تحتوي على شيء بعد)
ثانيا، المتغيرة countries ستعبر عن قائمة تتكون من 4 عناصر، كل عنصر منهم هو محتوى نصي لأنه داخل "" و يتم التمييز بينهم بإستخدام الفاصلة ,
ثالثا، بما أن المتغيرة countries تعبر عن قائمة (list) فيمكن إستخدام الوظائف التي تستخدم على القوائم تماما كما رأينا في حالة المتغيرات العادية. الوظيفة التي سنستخدمها هي append() و ستقوم بإضافة المعلومة النصية بين قوسين ("China") إلى القائمة countries ثم نكرر نفس الشيء بالنسبة ل "Germany"

بعد ذلك نبدأ بعرض محتوى القائمة:
أولا، print countries[1] تقوم بعرض المعلومة صاحبة الرتبة الثانية. نعم الثانية و ليست الأولى، لماذا؟ لأن أول عنصر في القوائم يعبر عليه بالرتبة صفر 0 و ليس 1، و بالتالي فإن العنصر 1 يعبر عن الرتبة 2

ثانيا print countries[-1] العنصر -1 هو العنصر الأخير، لماذا؟ لأن القوائم قد تختلف عن بعضها البعض من حيث عدد العناصر التي قد تعبر عنها. فإذا كان عدد العناصر مختلف كبف يمكن عرض آخر عنصر في كل قائمة؟ نستخدم [-1] لتعبير عليه.

ملاحظة: الطريقة الأخرى لعرض آخر عنصر هي print countries[len(countries)-1] في هذه الحالة ما نقوم به هو أننا نطلب حساب عدد العناصر الموجودة داخل القائمة ثم ننقص منه -1 حتى نستطيع التعبير عن آخر عنصر. لماذا نقوم بالنقص -1 لأنه إذا كانت القائمة تضم 6 عناصر مثلا و العنصر الأول يعبر عنه بـ 0 فإن آخر عنصر في القائمة سيكون 5 و ليس 6. لما كل هذا و الطريقة الأولى أبسط :)

ثالثا، print countries[2:4] تقوم بعرض كل عناصر القائمة بدءا من العنصر الثاني و حتى العنصر ما قبل الرابع.
و حتى يتضح الأمر أكثر فإن:
"Algeria" هو العنصر 0 و رتبته عندنا نحن هي 1
"Palestine" هو العنصر 1 و رتبته عندنا نحن هي 2
"UK" هو العنصر 2 و رتبته عندنا نحن هي 3
"France" هو العنصر 3 و رتبته عندنا نحن هي 4
"China" هو العنصر 4 و رتبته عندنا نحن هي 5
"Germany" هو العنصر -1 أو 5 و رتبته عندنا نحن هي 6

رابعا، print countries تقوم بعرض محتوى القائمة بأكمله


الآن ماذا لو أردنا حذف العنصر 0 من القائمة؟
نستخدم الأمر del و هو من الكلمات المفتحية/المحجوزة. سيكتب الأمر بهذه الطريقة:
del countries[0]

و هنا نقوم بحذف العنصر 0 الذي يحتوي المعلومات التي أردنا حذفها و هذا يتطلب منا معرفة مسبقة بمكانها، لكن ماذا لو أردنا حذف المعلومة أينما وجدة دون معرفة مسبقة بمكانا؟ في هذه الحالة نستخدم وظيفة remove() و ستكتب كما يلي:
countries.remove("China")
بحيث نطلب حذف أول عنصر من القائمة يحتوي على تلك المعلومة. لاحظ معي جيدا أول عنصر و ليس كل العناصر.

قد يظهر أن القوائم صعبة التعلم، لا تستسلم و تتوقف هنا. سبق و أن تطرقت إلى القوائم عند حلي لمشاكل المشروع Euler و يمكنك مراجعة الشرح هناك، كما سأتطرق إليها في تدوينات لاحقة. و لا تنسوا الإطلاع على كتاب بايثون للصديق أحمد يوسف، ستجدون فيه كل التفاصيل و التوضيحات اللازمة للتمكن من القوائم.

يونيو 21، 2009

مقارنة بين أداء بايثون و لغات البرمجة الأخرى

قضيت الفترة الأخيرة في إختبار أداء بايثون خصوصا أداء الحلاقات التسلسلية for و مقارنته بكل من روبي (Ruby)، بيئتشبي (PHP)، جنوا سي بلاس بلاس (GNU C++)، سي شارب (C#)، جافا (Java) و سكالا (Scala)

عند تعلمي لبايثون لاحظت أن مرونته و أدائه جد قويين في مجموعة من المهام، من بينها إنشاء قاموس يحتوي على 1 مليون مفتاح و قيمة في ثانية واحدة و أشياء أخرى. و أثناء حلي لمشاكل المشروع Euler Project لاحظت بعض البطء في الحلاقات التسلسلية for لكن لم أعر الأمر أي اهتمام لأن حاسوبي يعتبر من الديناصورات (P4 2.4Ghz) و عند تجربتي لنفس الكود على حاسوب آخر (Core 2 Duo 2.4Ghz) كان ينجز نفس المهمة 3 مرات أسرع.

و بعد وضعي للمشكلة رقم 5 تفضل الصديق محمد الجوهري بوضع الحل بلغة C# و عند تجربتي لحله تفاجأت من السرعة التي يتم العثور بها على الحل. قرأت الكود و جربته أكثر من مرة محاولا العثور على شيء يميزه، لكنه عادي. من هنا انطلقت رحلتي لفهم ما يجري في الحلاقات التسلسلية for في بايثون 2.6.2

الكود الاول:
في البداية كان الكود كالتالي و يستغرق 55 ثانية ليجد الحل:
n = 20
divs = [x for x in range(n, 0, -1)]
i = 0

while True:
    i = i+1
    nop = False
    for x in divs:      
        if (i*n) % x != 0:
            nop = True
            break

    if nop == False:
        print "\nThe answer is ", i*n
        break

هذا الكود رديء، و غيرته ليصبح كالتالي و هو يستغرق 40 ثانية:
i = 20
done = False
seq = range(2, 20+1)

while not done:
    for j in seq:
        if i % j != 0:
            break
        elif j == 20:
            done = True

    i += 20

print i-20

ثم قرأت حول طرق تحسين كود بايثون و وجدت من ينصح باﻹستخدام الدوال التالية lambda, map و filter بدلا من الحلقة التسلسلية for و كانت النتيجة كالتالي:

الكود الثالث يستغرق 5 دقائق و 34 ثانية:
i = 20
done = False
seq = range(2, 20+1)

while not done:
    if len(filter(None, map(lambda y: i % y == 0, seq))) == len(seq):
        done = True
        break
    i += 20
  
print i

الكود الرابع يستغرق هو أيضا 5 دقائق و 34 ثانية:
i = 20
done = False
seq = range(2, 20+1)

while not done:
    if False in map(lambda x: i % x == 0, seq):
        pass
    else:
        done = True
        break
    i = i + 20

print i

الكود الخامس: ثم بعد ذلك قمت بإدراج الكود الثاني داخل دالة و أصبح على الشكل التالي و يستغرق 24 ثانية:

def euler5():
    i = 20

    seq = range(2, 20+1)
    while True:
        for j in seq:
            if i % j != 0:
                break
            elif j == 20:
                return i

        i += 20

print euler5()


المهم ماذا يجري هنا؟ و لما كل هذا؟
بايثون يعتبر من لغات البرمجة التي تعتمد على التحديد الدينامكي أو المرن للمتغيرات (Dynamically Typed)، بمعنى أن المتغيرة a يمكن أن تحتوي على قيمة رقمية ثم تتحول لتعبر عن قيمة نصية بكل سهولة أثناء عمل البرنامج. و هذا ما يتشابه فيه كل من بايثون python، روبي ruby و بيئيتشبي php. بينما تعتمد كل من لغة سي بلاس بلاس c++ و جافا java و سي شارب c# و سكالا Scala على التحديد الثابت للمتغيرات (Statically Typed). طبعا هنا أقوم بشرح مبسط كما لم أتطرق للأفضلية لأن لكل منها (الغات) نقاط قوتها و ضعفها.

المهم هو أن هذه المرونة تتم على حساب جزء بسيط في ضعف الاداء في بعض العمليات. لكن المثير هو أن ضعف أداء الحلاقات التسلسلية for أكبر بكثير من المتوقع، فما هو السبب؟

اتضح لي فيما بعد أن الفلسفة التي يتبعها مطورو بايثون هي:
1. سهولة قراءة و وضوح الكود أهم من تعقيده لأجل تحسينه (optimization) للإستفادة من أخر جزء من الثانية.
2. هنالك قانون يسمى قانون مور (Moore's law) يقول أن كفائة العتاد تتضاعف كل 18 شهر تقريا. بمعنى أنه مع تطور العتاد سيسبح الفرق بسيطا بين الكود المُحسن و العادي.
3. و إذا كانت السرعة أولوية لا غنى عنها حينها يجب على المبرمج أن يستخدم قاعدة 90/10 بحيث يُفضل أن يكتب الجزء المسرع/المحسن بلغة C أو لغة أخرى.


النقطة المهمة التي تعجبني في مشاكل المشروع يولر Euler Project هي أن كل مشكلة تقريبا يمكن حلها بطريقة تقليدية و أخرى بإستخدام بعض الذكاء و التفكير مع مراعات أن يبقى الحل بسيطا :)
و كما قال لِيُوناردو دا فينشي (Leonardo da Vinci) "البساطة هي منتهى التعقيد"

و هذا هو ما قمت به في الحل الثاني للمشكلة رقم 5 بحيث تظهر النتيجة في جزء من الثانية.


لكن كيف هو أداء باقي لغات البرمجة الأخرى في إيجاد الحل للمشكلة رقم 5؟
1. روبي Ruby 1.8.7 أوجد الحل في دقيقتين و ثلاثين ثانية (2min 30s):
def GetResult()
    n = 20
    i = n
    while true do
        for j in 2..n do
            break if i % j != 0
            if j == n
                return i
            end
        end
        i += n
    end
end

puts GetResult()

ثم بعد تعديل الحلقة التسلسلية for أوجد الحل في دقيقتين و ثانية (2min 1s)
def GetResult()
    n = 20
    i = n
    seq = 2..n
    while true do
        for j in seq do
            break if i % j != 0
            if j == n
                return i
            end
        end
        i = i+n
    end
end

بيئيتشبي PHP 5.2.9 أوجد الحل في 21 ثانية:
$i = 20;
$n = $i;
$Done = false;
while (! $Done) {
    for ($j = 2; $j <= $n; ++$j) {
        if ($i % $j != 0) { break; }
        else {
            if ($j == $n) { $Done = true; }
        }
    }
    $i = $i + $n;
}

print $i - $n . "\n";

من خلال ما سبق يتضح أن php أسرع من python و ruby. و كلها تصنف كلغات ديناميكية النوعية.

لكن كيف هو أداء اللغات الثابتة النوعية ك C#, Scala و GNU C++ ؟ الجواب هو إنها فائقة السرعة مقارنة مع اللغات الديناميكية المجربة أعلاه.

بالنسبة لجنوا سي++ (GNU C++) أوجد الحل في ثاتية و نصف!:
#include <cstdlib>
#include <iostream>

using namespace std;

int main(int argc, char *argv[])
{
    int i = 20;
    bool Done = false;
    while (!Done) {
     for (int j = 2; j <= 20; ++j)
     {
         if (i % j != 0) break;
         else
         {
            if (j == 20) Done = true;
         }        
     }
     i += 20;
    }
   
    cout << endl << i-20 << endl;
    return EXIT_SUCCESS;
}

بالنسبة لسي شارب C# أوجد الحل في ثانيتين. (بإستخدام كود الصديق محمد الجوهري)

بالنسبة لجافا (java) أوجدت الحل في ثانية و ثمانية أعشار الثانية (1.8s)
public class Main {
    public static void main(String[] args) {
        int i = 20;
        boolean Done = false;
        while (!Done) {
            for (int j = 2; j <= 20; ++j) {
                if (i % j != 0) {
                    break;
                } else {
                    if ( j == 20) {
                        Done = true;
                    }
                }
            }
            i=i+1;
        }

        System.out.println(i-1);
    }
}

و أخيرا لغة سكالا (Scala) التي أوجدت الحل في ثانيتين و أربعة أعشار الثانية (2.4s)
def euler5(): Int = {
  var n = 20
  var i = n
  var done = true
  while (done)
  {
    var j = 2
    var iter = true
    while (iter && j < n+1)
    {
      if (i % j != 0) iter = false
      else j += 1
    }
    if (iter == true) done = false
    i += n
  }
  i-n
}

println(euler5())

كما نلاحظ فإن اللغات دات التحديد الثابت تعرض الحل في حدود ثانيتين، بينما اللغات دات التحديد الديناميكي تسغرق بعض الوقت لتصل إلى النتيجة. هذه الفرق عند إنجاز بعض المهام أو في بعض الحالات قد لا يعجب البعض، لكن في أغلب الأحيان لن تواجهوا هذا النوع من المتطلبات (السرعة أولا و أخيرا) و ستجدون في اللغات دات التحديد الديناميكي المرونة التي ستسمح لكم بتطوير برمجياتكم بسرعة أكبر و مدة أقصر. لكن إن صممت يمكن إعتبار Scala بديل أفضل لأنها تجمع بين مجموعة من المزايا و أنماط البرمجة.

الخلاصة:
1. أكتب دائما كود بسيط و تسهل قرائته.
2. الحلاقات التسلسلية for تستهلك الكثير من وقت المعالج، و يمكن تحسينها بإتباع بعض النصائح.
3. إدا كانت السرعة جد ضرورية في منطقة معينة من برنامجك حينها قم ببرمجة ذلك الجزء بلغة سي أو سي ++
4. سيحصل بايثون على آلة إفتراضية محسنة (LLVM) ستجعل أداءه مشابه للغة سي و سي++


تحديث 1: قمت بتجربة الكود الخامس بإستخدام الإصدار الجديد لبايثون 3.1 الذي توصل إلى الحل في 32 ثانية. (مازل أبطأ في هذا الإختبار لكن أفضل من الإصدار 3.0)

يونيو 14، 2009

مشروع Euler project: المشكلة رقم 10

المشكلة رقم 10:
مجموع العداد الأولية تحت 10 هو: 2 + 3 + 5 + 7 = 17

المطلوب:
أجد مجموع كل الأعداد الأولية تحت مليونين.

الحل:
import math

def isPrime(n):
    nbrs = [2] + range(3, int(math.sqrt(n))+1, 2)   
    for i in nbrs:
        if n % i == 0:
            return False
    return True

def sumPrimes(n):
    primes = [2] + [x for x in range(3, n, 2) if isPrime(x)]
    return sum(primes)

print sumPrimes(2000000)

الشرح:
1. نستدعي وحدة الرياضيات math بواسطة التعليمة import
2. نكتب دالة isPrime وظيفتها إختبار العدد الذي تتوصل به كمعيار n هل هو أولي أم لا. ذاخل هذه الذالة ننشئ قائمة بكل العداد بداية من 2 حتى جدع تربيع العدد n مع تفادي كل مضاعفات العدد 2
3. نكتب دالة وظيفتها إنشاء قائمة primes بكل الأعداد من 2 حتى n مع إجتناب مضاعفات العدد 2 و بشرط أن يكون أوليا، ثم بعد ذلك نستخدم الدالة sum حتى تحسب مجموع أعداد هذه القائمة.
4. يتم عرض النتيجة بإستخدام print

يونيو 13، 2009

مشروع Euler project: المشكلة رقم 9

المشكلة رقم 9:
تتألف ثلاثية فيثاغورس من الأعداد الصحيحة a < b < c بحيث تحقق العلاقة a2 + b2 = c2
مثال: 3^2 + 4^2 = 9 + 16 = 25 = 5^2

المطلوب:
توجد تحديدا ثلاثية فيثاغورس واحدة تكون فيها a + b + c = 1000
أجد abc

الحل الأول:
def pytha_Triplet(n):
    for a in range(1, n+1):
        for b in range(a+1, n+1):
            for c in range(n-a-b, b, -1):
                if a + b + c == n:
                    if (a**2) + (b**2) == (c**2):
                        return a*b*c

print pytha_Triplet(1000)

الشرح:
1. نقوم بتحديد دالة pytha_Triplet و تأخذ المعيار n. بداخلها يوجد حلقة تسلسلية تبدأ من 1 حتى آخر عدد (قيمة n). بداخلها توجد حلقة أخرى تبدأ من قيمة المتغيرة a+1 (الممثلة للمرحلة التي وصلت إليها الحلقة السابقة) و حتى آخر عدد ( وهو 1000 المعبر عنه ب n). و في داخل هذه الحلقة توجد حلقة أخرى تبدأ تنازليا من قيمة n-a-b حتى تصل إلى قيمة المتغيرة b (الممثلة للمرحلة التي وصلت إليها الحلقة الثانية). ثم بعد ذلك يتم إختبار مجموع a+b+c هل يتساوى مع n. إذا كان الشرط صحيحا يتم إجراء إختبار ثاني لمعرفة هل قيمة المتغيرتين a أُس 2 + b أُس 2 يتساوين مع قيمة المتغيرة c أُس 2. إدا كان الشرط صحيحا تخرج الدالة بنتيجة قيمة a*b*c
2. يتم عرض نتيجة الدالة pytha_Triplet

> كما تلاحظون هذه الحل يعتمد على طريقة تقليدية للعثور على ما نريد و هو يهدر الكثير من وقت المعالج.

الحالي الثاني (أسرع):
def pytha(n):
    a, b, c = 1, 2, n-3
    while (a < n/3):
        if a**2 + b**2 == c**2:
            return a*b*c
        elif c-1 > b+1:
            a, b, c = a, b+1, c-1
        else:
            a, b, c = a+1, a+2, n-(a+1)*2-1

print pytha(1000)

الشرح:
1. نكتب ذالة pytha و تأخد n كمعيار. بذاخلها يوجد:
2.1. يتم تعين قيمة 1 للمتغيرة a، و قيمة 2 للمتغيرة 2 و قيمة n-2 للمتغيرة c في آن واحد.
2.2. نحتاج إلى حلقة شرطية تبقى تدور ما دامت قيمة المتغيرة a أصغر من ثلث قيمة n. لماذ!؟ لأن ثلث قيمة n هو 333 و إدا كانت a = 333 فإن بالضرورة على b أن تكون أكبر من a بمعنى أنها على الأقل يجب أن تكون 334 و إذا كانت b = 334 فبالضرورة أن تكون قيمة c أكبر من b و بذلك فإن أصغر قيمة ممكنة ل c في هذه الحالة هو 335. و إذا قمنا بحساب مجموع a+b+c سنحصل على 1002 و بذلك فإدا وصلت قمية المتغيرة إلى ثلث قيمة n على الحلقة الشرطية بالخروج.
2.3. يتم إختبار قوة a في 2 + قوة b في 2 هل تتساوى مع قوة c في 2. إدا كان الشرط صحيح تخرج الدالة بمجموع ضرب قيمة a*b*c
2.4 إدا كان الشرط خاطئا يتم إختبار هل c-1 ما زالت أكبر من قيمة b+1. إدا كان الشرط صحيحا تبقى قيمة المتغيرة على حالها و تزيد قيمة b بـ 1 و تنقص قيمة c بـ 1 ثم تمر الحلقة إلى الدورة التالية.
2.5 أما إذا كان الشرطين السابقين خاطئين يتم تحديث قيمة a لتساوي a+1. ثم تصير b تساوي قيمة a+2 و قيمة c تساوي n ناقص قيمة (a+b) المعبر عنها بـ (a+1 مضروبة في 2) ناقص 1
3. يتم عرض نتيجة الدالة pytha بواسطة print

يونيو 12، 2009

مشروع Euler project: المشكلة رقم 8

المشكلة رقم 8:
أجد أكبر قيمة عددية مكونة من خمسة أرقام متتابعة في هذه السلسلة المكونة من 1000 رقم:

73167176531330624919225119674426574742355349194934
96983520312774506326239578318016984801869478851843
85861560789112949495459501737958331952853208805511
12540698747158523863050715693290963295227443043557
66896648950445244523161731856403098711121722383113
62229893423380308135336276614282806444486645238749
30358907296290491560440772390713810515859307960866
70172427121883998797908792274921901699720888093776
65727333001053367881220235421809751254540594752243
52584907711670556013604839586446706324415722155397
53697817977846174064955149290862569321978468622482
83972241375657056057490261407972968652414535100474
82166370484403199890008895243450658541227588666881
16427171479924442928230863465674813919123162824586
17866458359124566529476545682848912883142607690042
24219022671055626321111109370544217506941658960408
07198403850962455444362981230987879927244284909188
84580156166097919133875499200524063689912560717606
05886116467109405077541002256983155200055935729725
71636269561882670428252483600823257530420752963450

الحل:
nbrs = """73167176531330624919225119674426574742355349194934
96983520312774506326239578318016984801869478851843
85861560789112949495459501737958331952853208805511
12540698747158523863050715693290963295227443043557
66896648950445244523161731856403098711121722383113
62229893423380308135336276614282806444486645238749
30358907296290491560440772390713810515859307960866
70172427121883998797908792274921901699720888093776
65727333001053367881220235421809751254540594752243
52584907711670556013604839586446706324415722155397
53697817977846174064955149290862569321978468622482
83972241375657056057490261407972968652414535100474
82166370484403199890008895243450658541227588666881
16427171479924442928230863465674813919123162824586
17866458359124566529476545682848912883142607690042
24219022671055626321111109370544217506941658960408
07198403850962455444362981230987879927244284909188
84580156166097919133875499200524063689912560717606
05886116467109405077541002256983155200055935729725
71636269561882670428252483600823257530420752963450"""

nbrs = nbrs.replace('\n','')
product = 0

for i in range(len(nbrs)-4):
    p = 1

    for i in nbrs[i:i+5]:
        p *= int(i)

    if p > product:
        product = p

print product

الشرح:
1. المتغيرة nbrs تحتوي علة كل الأرقام لكن بصفة نصية. لاحظ أنها بين """. كما أن الأرقام كتبت موزعة على عدد من الأسطر و بالتالي في إن كل سطر يعبر عنه بحرف خفي يعبر عنه ب '\n' و يجب التخلص منه.
2. نتخلص من حرف '\n' من خلال تعويضه بالفراغ nbrs.replace('\n','')
3. نقوم بأخد و إختبار قيمة كل خمسة أرقام متتالية في تلك السلسلة من الأرقام. ثم نحتفظ بأعلى قيمة ناتج عملية ضرب تلك الارقام في بعضها البعض في المتغيرة product
4. بعد الإنتهاء من تلك السلسلة يتم عرض أعلة قيمة ناتج عثرنا عليها.

يونيو 11، 2009

مشروع Euler project: المشكلة رقم 7

المشكلة رقم 7:
من خلال عرض قائمة بالأعداد الأولية الستة الأولى: 2 ، 3 ، 5 ، 7 ، 11 و 13، نرى أن العدد السادس في القائمة هو العدد الأولي 13.

المطلوب:
ما هو العدد الأولي المرتب 10001 في قائمة الأعداد الأولية؟

الحل:
import math

def isPrime(n):
    nbrs = [2] + range(3, int(math.sqrt(n))+1, 2)   
    for i in nbrs:
        if n % i == 0:
            return False
    return True

def findPrime(position):
    i = 1
    counter = 1 # 1 instead of 0 because 2 won't be tested
    while True:
        i += 2
        if isPrime(i):
            counter += 1
        if counter == position:
            return i

print findPrime(10001)

الشرح:
1. نقوم بإستدعاء الوحدة math  التي تضم دوال العمليات الرياضية.
2. نقوم بتحديد دالة isPrime التي ستقوم بإختبار العدد المعطي في المعيار (n) هل هو اولي أم لا. و تقوم بذلك من خلال إنشاء قائمة بكل الأعدد التي هي أصغر من قيمة (n) حتى تجري عملية القسمة علىها باحثتا عن عدد لا يقبل القسمة إلا على نفسه. و حتى يتم تسرع عملية البحث يتم إستخدام جدع تربيع قيمة العدد (n) بالإضافة إلى تخطي كل العداد التي تقبل القسمة على 2
3. إنشاء دالة findPrime لإيجاد العدد الاولي صاحب الرتبة 10001 في قائمة الأعداد الأولية. تقوم هذه الدالة بالبحث عن العدد صاحب الرتبة المطلوبة (position) و ذلك من خلال الدوران في الحلقة الشرطية while. في كل دورة يتم إختبار عدد جديد، إذا كان أولي يتم تحديث العداد counter ثم إختبار الرتية اتي وصلنا إليها، و إذا كانت هي الرتبة المناسبة يتم الخروج من الدالة بالنتيجة المخزنة في المتغيرة i.
4. يتم عرض النتيجة بواسطة print


كما تلاحظون فقد إستخدمت ما تعلمناه في تجربتنا الأخيرة في تحسين كود بايثون، حيث إستخدمنا الدوال بدلا من كتابة الكود في الجزء العام بالإضافة إنشاء القوائم range خارج الحلاقات التسلسلية.

يونيو 10، 2009

مشروع Euler project: المشكلة رقم 6

المشكلة رقم 6:
مجموع مربع الأعداد الطييعية العشرة الأولى هو:
1^2 + 2^2 + ... + 10^2 = 385

و مربع مجموع الأعداد العشرة الطبيعية الأولى هو:
(1 + 2 + ... + 10)^2 = 55^2 = 3025

و الفرق بين النتيجتين هو:  3025 - 385 = 2640


المطلوب:
أجد الفرق بين مجموع مربع الأعداد الطبيعية المئة الأولى و مربع جمعها.


الحل الأول:
def sumSquares(n):
    r = 0
    for i in range(1, n+1):
        r = r + (i ** 2)
    return r

def squaresSum(n):
    r = 0
    for i in range(1, n+1):
        r = r + i
    return (r**2)

print  squaresSum(100) - sumSquares(100)
الشرح:
1. نخصص دالة لحساب مجموع مربع كل عدد إسمها sumSquares() بحيث تأخد المعيار (Parameter) n و تستخدم قيمته كأعلى عدد في سلسلة الأعداد 1 إلى n. ثم بعد ذلك نستخدم حلقة تسلسلية لحساب تربيع كل عدد (i**2) في السلسلة ثم إضافة الخارج على المجموع r. و بعد الإنتهاء من الحلقة تخرج الدالة بالنتيجة المخزنة في r.
2. الدالة الثانية squaresSum() تحسب تربيع مجموع الأعداد. و هس تشبه الدالة الأولى في التركيبة غير أن النتيجة مختلفة.
3. ثم نقوم بعرض النتيجة مستخدمين print التي تقوم بإستدعاء الدالة الاولة و الثانية ثم تعرض فرق النتيجة.

ملاحظة: إستخدام علامة النجمة مرتين ** يفيد حساب مربع عدد ما.

الحل الثاني:
كما تفضل الصديق أحمد يوسف في حله، يمكن كتابة الحل في سطر واحد:
print  sum(range(100+1))**2 - sum(x**2 for x in range(100+1))

الشرح:
1. يتم إنشاء قائمة تحتوي على سلسلة من الأرقام تبدأ من 0 إلى 100 ثم يتم حساب مجموع الأرقام في هذه الأرقام على الشكل التالي 0+1+2+3..+100 ثم يتم حساب مربع هذا المجموع.
2. يتم إنشاء قائمة تحتوي على مئة و واحد عنصر (0 إلى 100)، كل عنصر هو عبارة عن عدد كان أصله هو مربع رتبته في القائمة، بمعنى 0^2 و 1^2 و 2^2 ... إلى 100^2. ثم يتم حساب مجموع هذه الأعداد بواسطة الدالة sum() تماما كالجزء الأول.
3. بعد ذلك تقوم print  بعرض فارق المجموعين.

نعم، هذا الحل من حلول النينجا Python Ninja :)

يونيو 09، 2009

مشروع Euler project: المشكلة رقم 5

المشكلة رقم 5:
العدد 2520 هو أصغر عدد يمكن أن يقسم على كل عدد بدءا من 1 إلى 10 دون أي باقي.

المطلوب:
ما هو أصغر عدد يمكن قسمته على كل الأعداد من 1 إلى 20 دون أن يكون هنالك باقي (القسمة بالتساوي)


الحل الأول (إستغرق 24 ثانية على حاسوبي):
def euler5():
    i = 20
    seq = range(2, 20+1)
    while True:
        for j in seq:
            if i % j  !=  0:
                break
            elif j == 20:
                return i

        i += 20


print euler5()
الشرح:
1. نستخدم الكود داخل دالة حتى تزيد من سرعة الأداء. الدالة تم تحديدها بواسطة الكلمة المفتحية def يليها إسمها euler5 المتبوع ب () ثم :

2. المتغيرة i هي التي ستتزايد قيمتها تصاعديا حتى تصل إلى الرقم الذي يمكنه القسمة على جميع الأعداد من 1 إلى 20
3. المتغيرة seq هي قائمة بالأرقام التي سيتم إستخدامها كقاسم. القائمة تحتوي على كل الأعداد من 2 إلى 20
4. الحلقة شرطية while. و بالصيغة التي كُتبت بها فستبقى تدور إلى الأبد أو حتى يتم كسرها بتعليمة break أو return

5. الحلقة التسلسلية for التي تدور من أول عدد في القائمة seq إلى آخر عدد فيها. في كل دورة تأخد المتغير j قيمة العدد التالي من القائمة
6. الجملة الشرطية if التي تقوم بإجراء القسمة لإختبار قيمة الباقي هل هي 0 أم لا. إدا كان الباقي (و ليس الخارج) لا يساوي 0 يتم كسر الحلقة for بواسطة التعليمة break و ذلك لنختصر المسافة لأنه لا دعي لإختبار كل الأعداد المتبقية في القائمة seq إن كان العدد الذي نحن بصدده باقي قسمته لا بساوي 0. بمعنى ليس قاسما طبيعيا. و بعد دلك ينتقل الكود للسطر الذي يحتوي على i += 20 حتى يتم الصعود بقيمة 20 في كل دورة من دورات الحلقة while.
7. أما إدا كانت كل الأعداد المتواجد في القائمة seq تقبل القسمة بشكل طبيعي على قيمة المتغيرة i، فبالضرورة إدن أن قيمة المتغيرة j ستكون مساوية ل 20 و ذلك لأنه آخر رقم في القائمة قابل للقسمة بشكل طبيعي. بمعنى أننا إجتزنا كل الأعداد في القائمة حتى وصلنا إلى 20. و بعد التأكد من ذلك نخرج من الدالة euler5() بنتيجة المتغيرة i و تم عرضها من طرف الدالة print


الحل الثاني (يتوصل إلى النتيجة بشكل آني):
def isPrime(value):
    for i in range(2, value):
        if value % i == 0:           
            return False
    return True


def sumMultiply(seq):
    r = 1
    for i in seq:
        r = r * i
    return r


def findDivisible(value, seq=[]):
    multiplier = 1   
    while True:
        for i in seq:
            if (value * multiplier) % i != 0:
                multiplier += 1
                break
            elif i == seq[-1]:
                return (value * multiplier)


nbr = 20
divs = [x for x in range(nbr, 1, -1)]
primes = sumMultiply(filter(isPrime, divs))

print findDivisible(primes, divs)

الشرح:
يبدو و كانه صعب لكنه سهل :)

1. قمنا بإضافة دالة isPrime(value) التي ستقوم بمعرفة هل العدد الذي حصلت عليه من المعيار value أهو عدد أولي ام لا. هذه الدالة سيتم إعتمادها و تحسينها في مشاكل مستقبلية.
2. دالة sumMultiply(seq) تقوم بإعطا الخارج بعد قيامها بعملية ضرب كل أعداد القائمة seq في بعضها البعض.
3. دالة findDivisible(value, seq=[]) تقوم بالبحث عن أول قاسم للأعداد التي توصلت بها من القائمة seq.

فكرة هذا الحل هو إيجاد الأعداد الأولية في قائمة الأعداد من 2 إلى 20 ثم إجراء عملية ضرب بعضها في بعض، و العدد الذي نحصل عليه من هذه العملية يتم إستخدامه كأساس/كمنطلق يتم إستخدامه للبحث عن مضاعف له يقبل القسمة على كل الأعداد من 2 إلى 20. و هذا هو ماتقوم به الأسطر الأخيرة.